
全球最大,谷歌Figure排队买!这个团队,撑起硅谷最火机器人
全球最大,谷歌Figure排队买!这个团队,撑起硅谷最火机器人Maxinsights累计交付超200万小时第一人称数据,成为Figure、Genesis AI、Dyna Robotics等硅谷头部具身智能团队的数据基础设施,凭借150万小时高质量数据存量与全链路算法处理能力推动具身智能Scaling Law持续验证。
来自主题: AI资讯
8512 点击 2026-09-11 16:03

 搜索
Maxinsights累计交付超200万小时第一人称数据,成为Figure、Genesis AI、Dyna Robotics等硅谷头部具身智能团队的数据基础设施,凭借150万小时高质量数据存量与全链路算法处理能力推动具身智能Scaling Law持续验证。
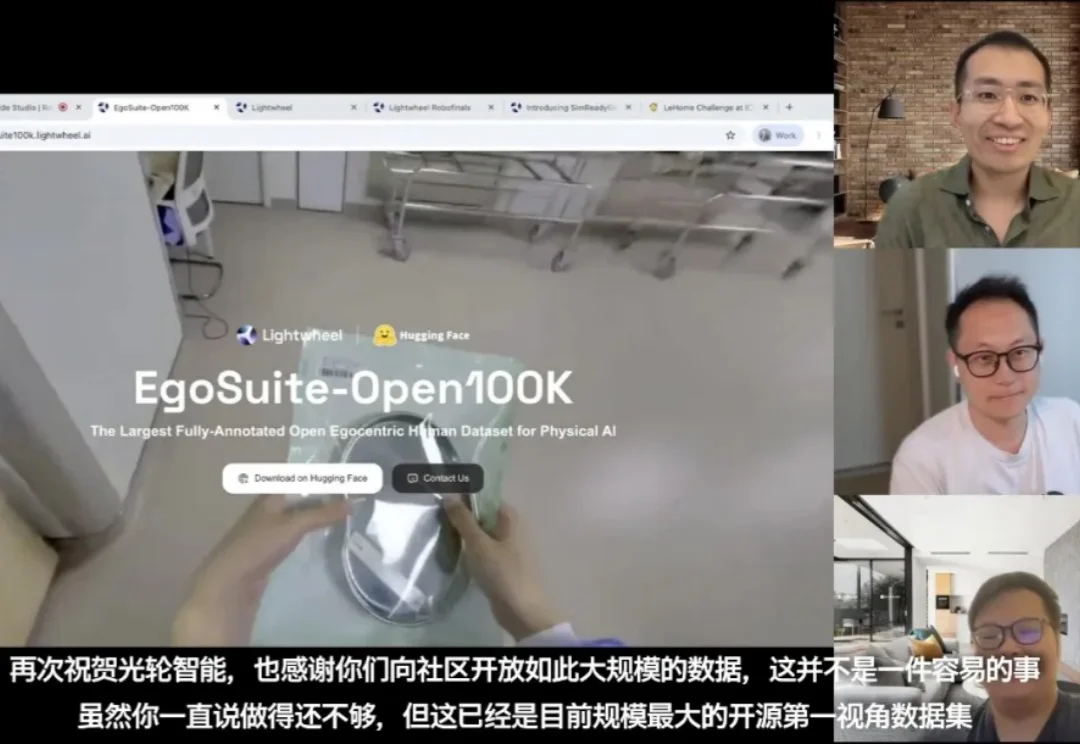
近日,机器人圈知名播客节目 RoboPapers 更新了一期专访,对象是光轮智能创始人兼 CEO 谢晨博士。这期节目的采访人是 RoboPapers 播客联合主持人 Michael Cho 和新加坡国立大学(NUS)助理教授 Jiafei Duan。后者是 MolmoAct 系列机器人模型的作者,研究方向正是机器人基础模型与可扩展数据采集。
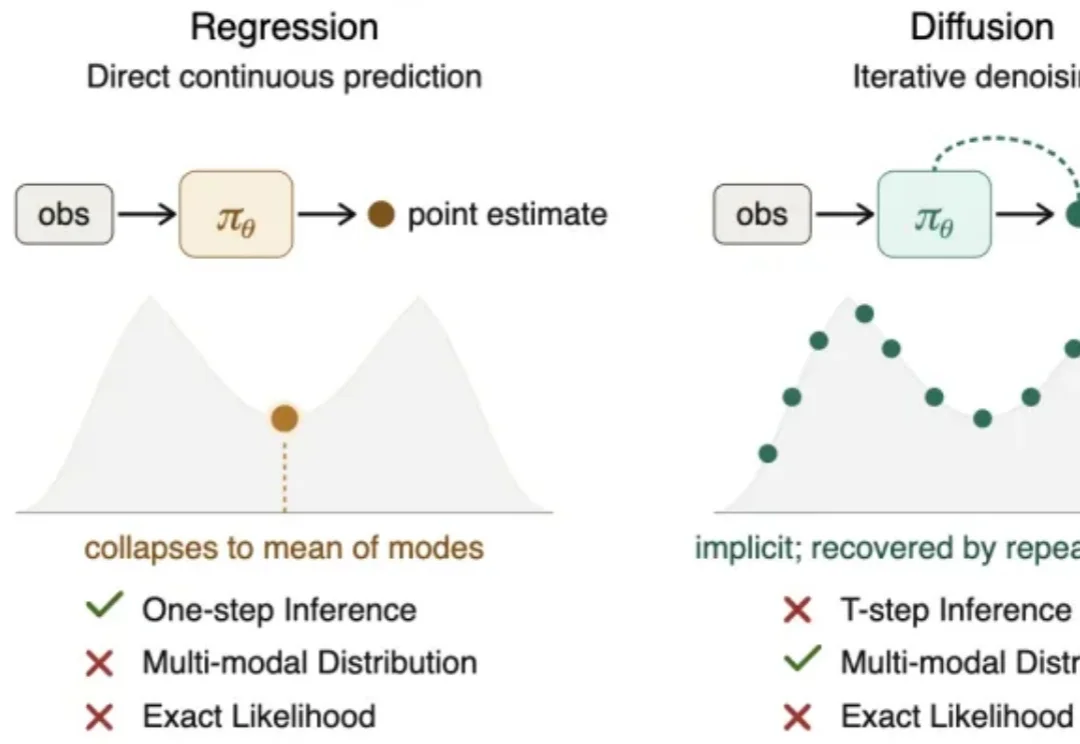
If I Had One Bet on Robot Learning, I’d Bet on Cross-Entropy. 大语言模型的成功揭示了一个适用于一维序列数据的清晰 Scaling Law:通过自回归训练,并采用交叉熵(cross-entropy)目标函数预测下一个 token 的概率分布,模型能够建模非常复杂的语义概率分布,并随着数据规模和模型规模的增长持续提升性能。
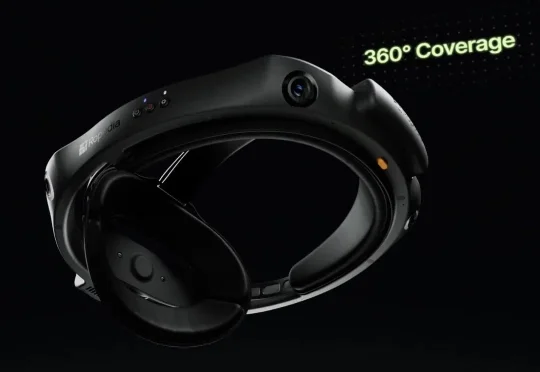
新加坡Physical AI公司Ropedia正式发布新一代多模态采集系统HOMIE Gen2,以4目全景360°、十余种模态同步采集与开箱即用的高精度训练级数据,将人类经验规模化为机器人可直接学习的训练数据,推动Physical AI的经验规模化落地。
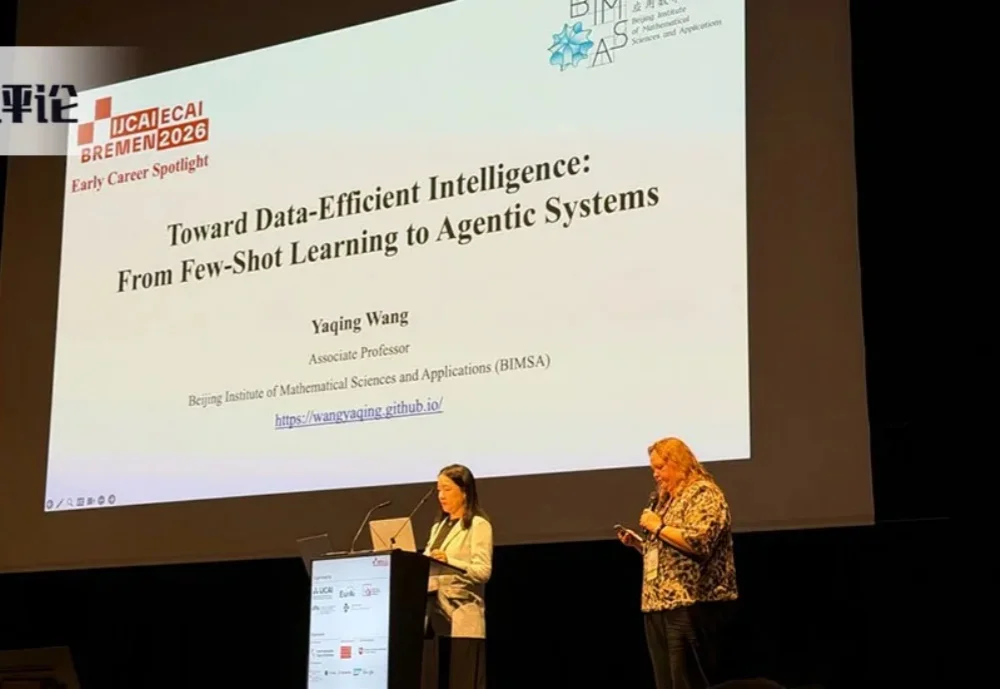
真正的智能,在于能否基于有限的数据,实现可靠的泛化与迁移。

Scaling Law还在,但今天的大模型,已经不能只靠“参数量”来理解Scaling了。

斯坦福最近公开了一门课的录像,叫 CS329A,主题是 Self-Improving AI Agents(自我改进的 AI agent)。两位主讲教授,Aakanksha Chowdhery 和 Azalia Mirhoseini,都有极深的工业背景。Aakanksha 曾是 Google 540B 参数 PaLM 模型的技术负责人,也参与了 Gemini 的研发
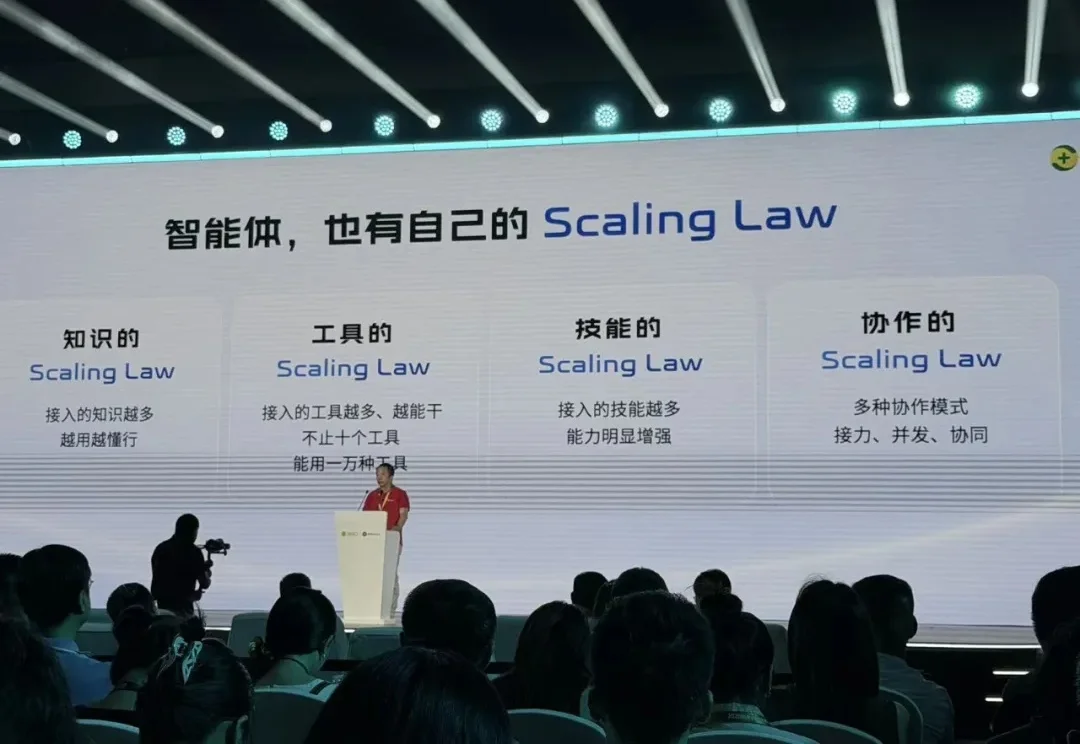
之前去了纳米Work的发布会,对技术的探索、对智能体Scaling Law的判断,很有前瞻性。
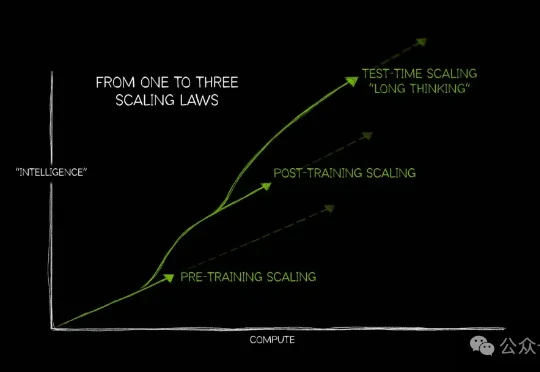
新智元报道 大模型变强,过去靠两条路。 做大——Scaling Law出现后,参数从百亿推向千亿,算力支出一路飙升。 想久——o1带火思考模型,用更长的思维链、更多推理时间换结果。 问题是,除了Sca
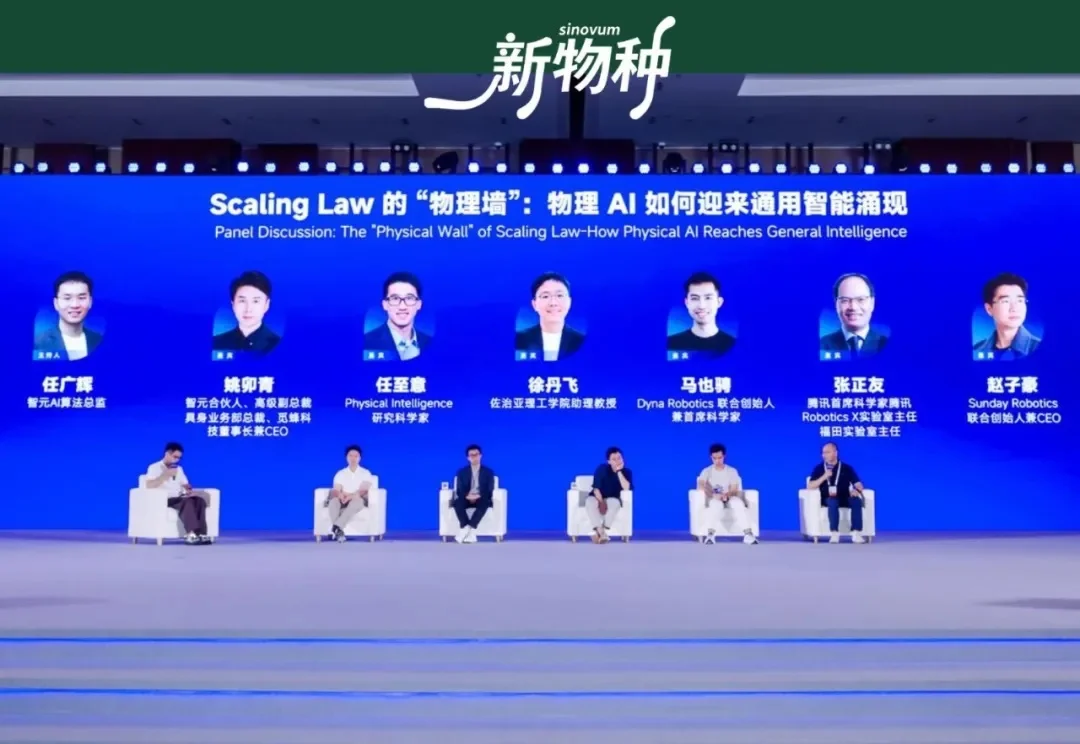
模型决定起点,数据定义终局。